01 / 产品介绍
什么是网页截图 API?
AdsCrawl 网页截图 API 通过 POST /screenshot 在浏览器中打开 URL 并返回 PNG。使用 fullPage 截取整页,或使用 selector 截取第一个匹配元素。成功响应是图片二进制数据,应保存为文件,而不是按 JSON 解析。
网页采集 API:应用除了图片还需要数据时,提取命名文本或数值字段。
Playwright 云浏览器:截图前需要导航、填写表单或点击时,使用 Playwright 脚本控制流程。
问题直答
无头浏览器架构中,如何同时完成网页采集和截图?
提取数据和截图必须对应同一浏览器状态时,使用一个 Remote CDP 会话:导航、等待所需内容、读取字段、截图,再清理。独立 URL 截图可调用 POST /screenshot 获取 PNG,命名字段可调用 POST /spa-extract;两个独立请求会分别加载页面,观察到的内容可能不同。
- 简单截图由队列按每次一个 URL 调用接口,检查成功后保存 PNG 响应。
- 需要登录、点击或共享页面状态时,在同一个 CDP 会话中运行 Playwright 或 Puppeteer,等待目标元素后再提取和截图。
- 一起保存 URL、截取时间和输出,两个结果保存后删除会话。
实际效果
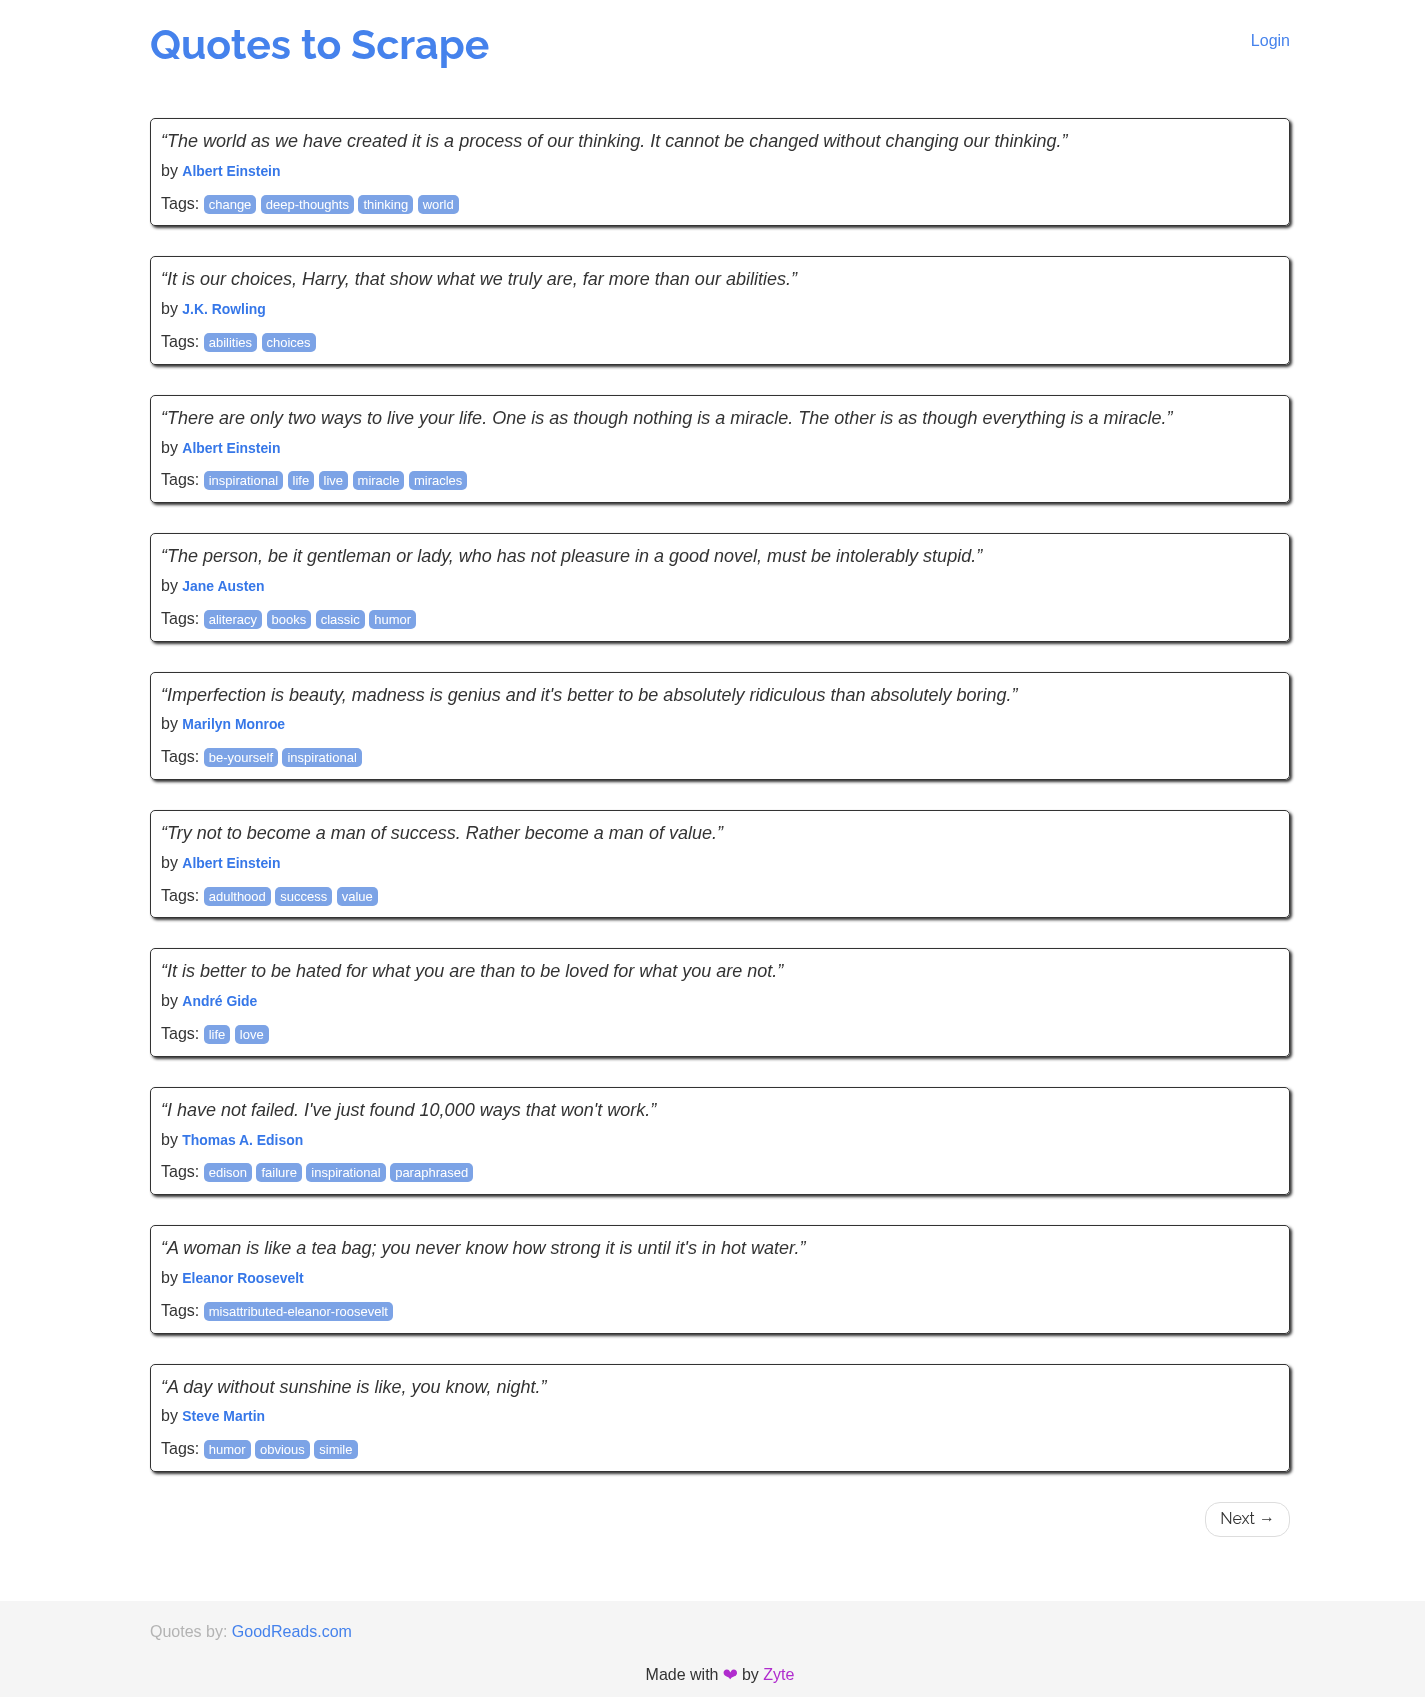
直接查看 API 实际返回的 PNG。
这是 Quotes to Scrape 经 JavaScript 渲染后的整页截图。滚动预览或下载原始 PNG,检查文字、布局与页面底部。
实际采集于
- 输出格式
- PNG
- 字节
- 158,727
- HTTP
- 200
向下滚动查看完整截图原始 PNGPNG
1425 × 1698
实际文件尺寸(像素)- 采集范围
- 整页
- 请求视口
- 1440 × 900
- 文件大小
- 158,727 bytes
下载并检查原始截图 → 如何核对这次结果
请求视口为 1440 × 900。返回的整页 PNG 高于该视口,并包含 Next 链接与页脚。
单次公开页面演示,结果反映采集时的页面状态;目标网站、加载条件和请求设置会影响后续结果。
02 / 适用场景
适合哪些任务?
01预览完整页面
为审核工具和内部网站预览生成整页图片。保留目标 URL,方便审核者确认来源。
02聚焦一个组件
使用精确的 CSS 选择器截取图表、卡片或其他元素,接口会截取第一个匹配元素。
03保留视觉上下文
把截图与监控结果或研究记录一起保存。截图记录请求时的渲染状态,不保证页面以后保持相同外观。
03 / 快速开始
从一个完整流程开始
- 设置服务端 API Key 并选择目标 URL。
- 整页使用 fullPage,单个元素使用 selector。
- 调用 POST /screenshot 并按文档设置合适的等待条件。
- 检查响应状态,将成功的二进制响应保存为 screenshot.png。
示例环境:Bash 与 cURL。 先在服务端设置 ADSCRAWL_API_KEY 环境变量。
完整参数与响应说明 →curl --fail-with-body -sS \
-X POST "https://api.adscrawl.net/screenshot" \
-H "x-api-key: $ADSCRAWL_API_KEY" \
-H "content-type: application/json" \
-d '{
"url": "https://www.adscrawl.net",
"fullPage": true,
"waitUntil": "load"
}' \
--output screenshot.png
# Add "selector": "main" to capture one element.
工作流指南
选择截图范围与页面加载条件
网页截图是否可用,取决于截取范围和页面当时的状态。设置一致的视口、选择截图范围,并在用于报告或对比前检查生成的 PNG。
截取完整页面
将 fullPage 设置为 true,并省略 selector,截取视口之外的页面内容。需要多次请求保持一致布局时,显式设置 viewport 的宽度和高度。
查看整页截图参数 →截取图表、卡片或指定区域
提供 CSS selector,截取第一个匹配元素。selector 的优先级高于 fullPage,即使 fullPage 为 true 也只截取匹配元素。未匹配到元素时返回 HTTP 422。
查看元素截图参数 →完成多步交互后截图
需要先导航、填写表单或完成多次点击时,使用 Playwright 浏览器流程。脚本可以等待所需的应用状态,再执行截图。
构建 Playwright 操作流程 →如何确认结果可用
- 根据目标页面选择 waitUntil。持续长轮询的页面可能使 networkidle 超时;导航完成也不代表所有动态组件已经加载完成。
- 将成功响应作为 PNG 二进制保存,例如使用 cURL --output screenshot.png;先检查 HTTP 状态,再将响应当作图片处理。
- 打开结果图片,确认截图范围、文字和内容加载状态。需要跨时间对比时,保持 viewport 设置一致。
04 / 限制与计费
接入前需要了解
注册获 500 一次性积分。Hobby、Starter 和 Pro 每月分别为 9、49 和 199 美元。启动持久云浏览器需要付费套餐。
比较套餐与额度 →- 失败响应可能是错误文本而非 PNG,保存前需检查 HTTP 状态。
- 懒加载图片或延迟组件可能需要额外的受支持等待选项,load 不代表所有内容都已就绪。
- 选择器需足够精确且元素确实存在,单次元素截图不会捕获所有匹配元素。
- 截图消耗额度和浏览器运行能力,高频调度前请确认价格与额度。
- 多个 URL 需要由应用组织独立的 POST /screenshot 请求,按顺序执行或控制在账号并发额度内。此示例每次请求一个 URL,不是批量接口。
- waitUntil 支持 domcontentloaded、load(默认)与 networkidle。networkidle 等待连续 500 毫秒没有网络连接,持续联网的页面可能超时。timeoutMs 接受不超过 3,600,000 的正整数,无效值回退到服务端默认值。
- selector 未匹配到元素时返回 HTTP 422 与 CONTENT_SELECTOR_NOT_FOUND;成功响应是二进制 image/png。
API Key 仅保存在服务端。遇到 HTTP 402 请检查额度,遇到 429 请降低并发并退避重试。
05 / FAQ
常见问题
可以只截图表吗?
可以。提供图表容器的 CSS 选择器,接口截取第一个匹配元素。
能通过一次 API 调用同时获取整页截图和提取的文本吗?
不能。POST /screenshot 只返回 PNG;文本需要另外调用 POST /html 或 POST /spa-extract。若两个结果必须来自同一页面状态,可在同一个 Remote CDP 会话中使用 Playwright 或 Puppeteer:等待内容、读取文本、截图,再清理会话。这是多步浏览器流程,不是一次组合 API 响应,也不是 OCR。
为什么部分动态内容没有出现在截图中?
截图反映截取时的页面状态,请检查目标网站的加载行为,并选择与之匹配的受支持等待设置。