01 / 产品介绍
什么是网页采集 API? AdsCrawl 网页采集 API 通过 POST /spa-extract 从浏览器渲染的网站中提取指定字段。字段可使用 DOM 选择器或受支持的网络响应来源。需要渲染标记或可读正文时,则使用 POST /html 并选择对应输出模式。
网页转 Markdown API :流程需要段落正文,而非固定的一组命名字段时,选择可读 Markdown 输出。
远程 CDP 浏览器 :需要交互式工作流时,在同一脚本会话内完成导航、点击和提取。
对比命名字段提取与 Firecrawl 的托管数据流程 →
实际效果
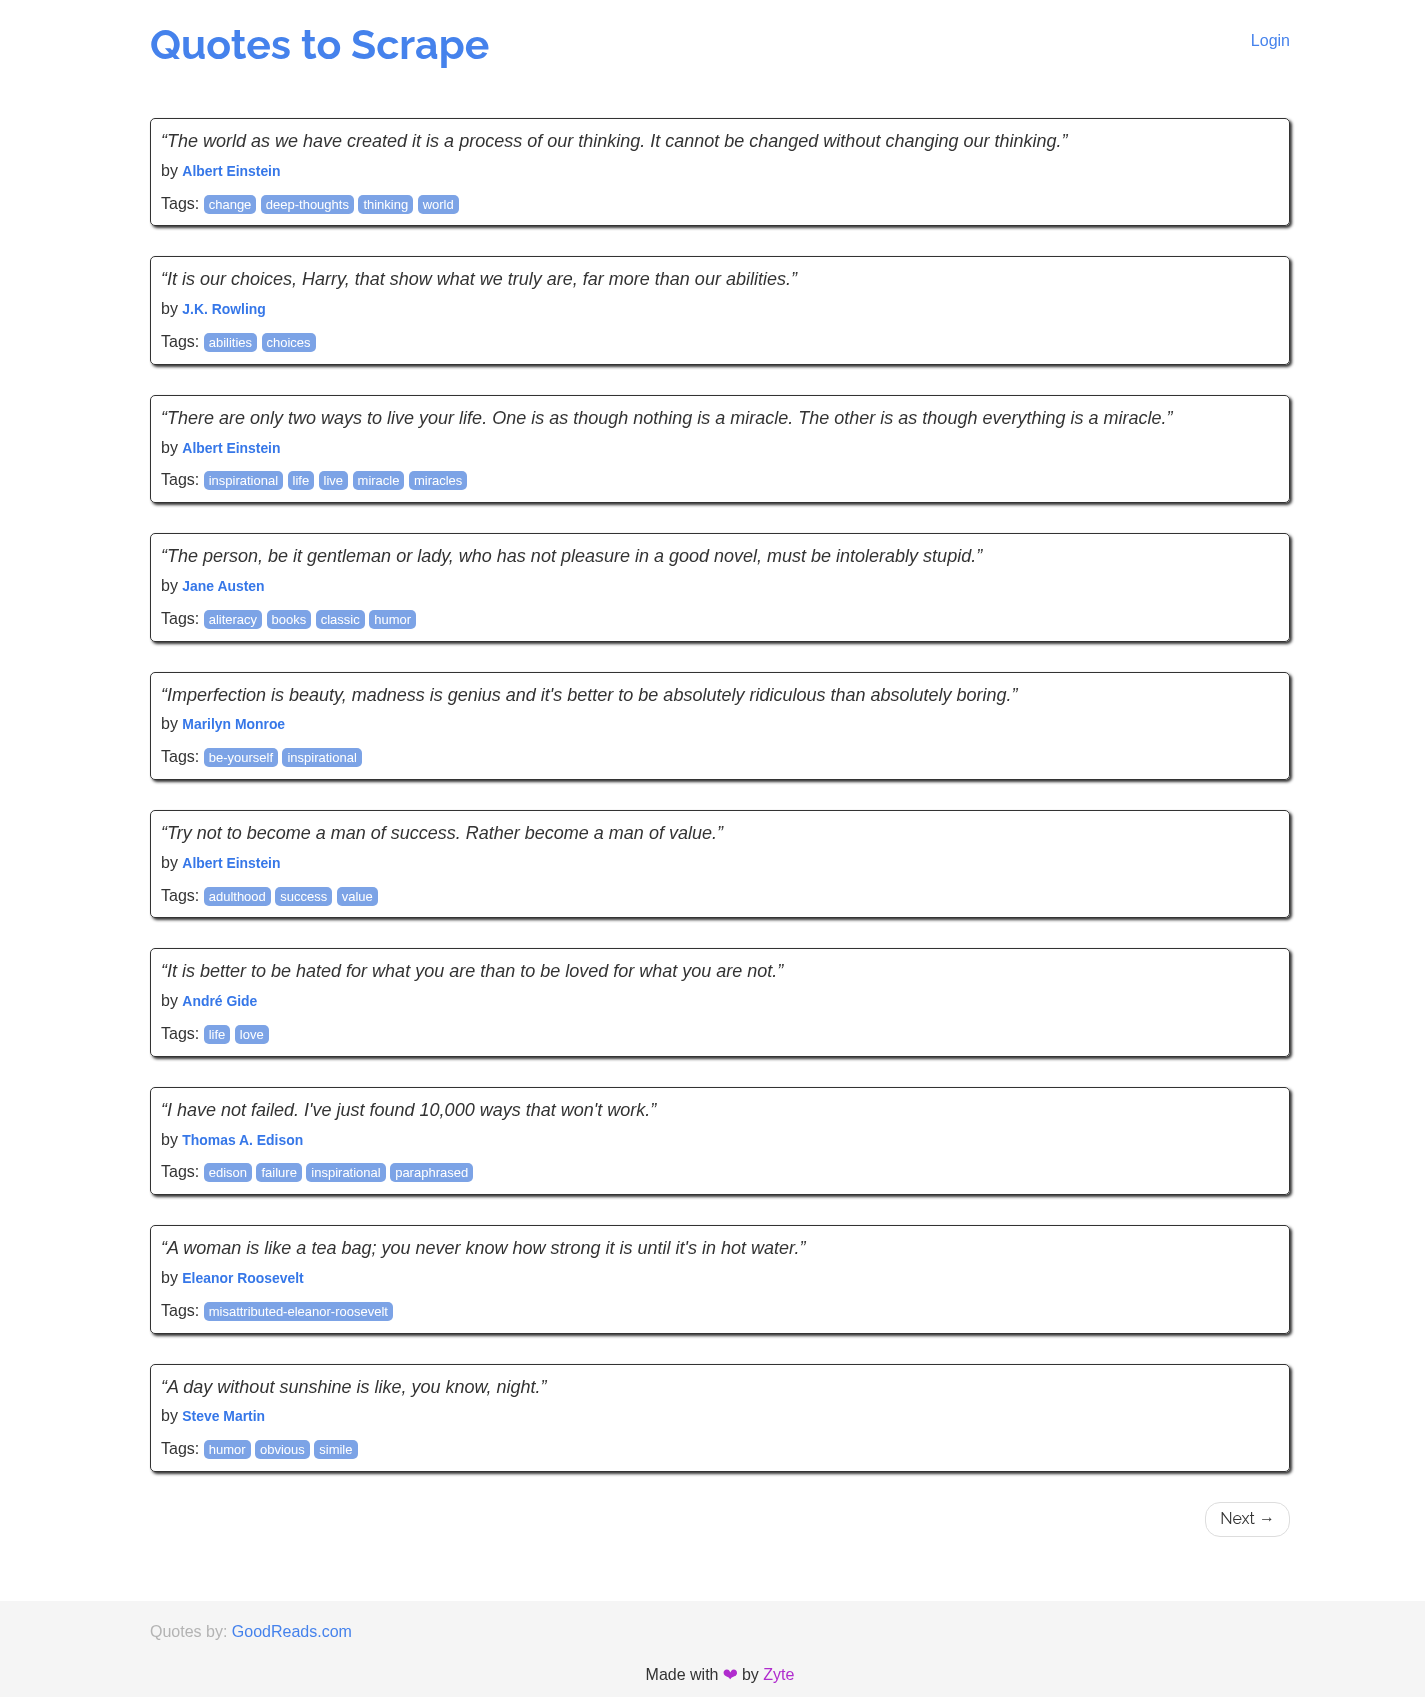
从 JavaScript 页面,提取两个可用字段。 Quotes to Scrape 使用 JavaScript 生成名言元素。这次实际请求从渲染后的 DOM 中读取了第一条名言及其作者。
实际采集于2026-11-04
返回字段 2
缺失字段 0
HTTP 200 向下滚动查看完整截图 {
"data": {
"author": "Albert Einstein",
"quote": "“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”"
},
"missingFields": [],
"mode": "extract",
"page": {
"url": "https://quotes.toscrape.com/js/",
"title": "Quotes to Scrape"
}
}
如何核对这次结果 将 data.quote 和 data.author 与源页面第一条名言对照。missingFields 为空,表示这次请求的两个字段均已找到。
用自己的页面试试 → 单次公开页面演示,结果反映采集时的页面状态;目标网站、加载条件和请求设置会影响后续结果。
验证一个完整任务
从动态网页得到可验证的 JSON 01 等待目标元素 对 https://quotes.toscrape.com/js/ 调用 POST /spa-extract。使用 waitFor.selector: .quote .text,确保正文出现后再读取字段。
02 定义并验证字段 quote 使用 .quote .text,author 使用 .quote .author,两者均设为 required、parse: string。检查 data.quote 非空、data.author 为 Albert Einstein、missingFields 为空。
03 测试失败分支 把必填字段的选择器改成一个不存在的元素,在测试流程中确认它会被拒绝或进入缺失字段处理。HTTP 200 本身不能证明结果符合你的数据要求。
参考记录采集于 2026-11-04,为一次 AdsCrawl 运行;不代表所有站点的成功率、性能或费用。请下载原请求与结果,在你的目标页重新验证。
02 / 适用场景
适合哪些任务? 01 提取明确字段 为名称、标题或其他值定义 CSS 选择器。为每个字段命名,让后续代码无需依赖整个页面的标记结构。
02 读取动态数据 页面加载过程中获取 JSON 时,可以使用受支持的网络字段。匹配和提取规则以接口文档为准。
03 检查结果完整性 同时检查返回值与 missingFields,在数据进入监控或研究流程前发现选择器变化与加载不完整的问题。
03 / 快速开始
从一个完整流程开始 创建 API Key 并保存在服务端环境变量中。 检查目标页面,为每个必要字段确定选择器。 调用 POST /spa-extract,将 mode 设置为 extract 并提供 fields。 检查返回值与 missingFields,再使用结果。 示例环境:Bash、cURL 与 jq。 先在服务端设置 ADSCRAWL_API_KEY 环境变量。
完整参数与响应说明 → curl --fail-with-body -sS \
-X POST "https://api.adscrawl.net/spa-extract" \
-H "x-api-key: $ADSCRAWL_API_KEY" \
-H "content-type: application/json" \
-d '{
"url": "https://www.adscrawl.net",
"mode": "extract",
"fields": {
"title": {
"source": "dom",
"selector": "h1",
"parse": "string"
}
}
}' \
--output extraction.json || exit 1
# Requires jq. Reject incomplete data before using the result.
jq -e '
.mode == "extract" and
(.missingFields | type == "array" and length == 0) and
(.data.title | type == "string" and length > 0)
' extraction.json >/dev/null || {
printf '%s\n' 'Extraction is incomplete. Check missingFields, selectors and wait settings.' >&2
exit 1
}
# Read .data.title in your application; keep extracted content out of logs.工作流指南
选择输出形式,再校验提取字段 根据需要的结果选择接口。HTTP 200 本身不能证明所有请求字段都已找到。
成功响应示例 按 extract 响应契约编写的示意数据,并非实际请求记录。请求字段从 data.title 读取。
{
  "mode": "extract",
  "page": {
    "url": "https://example.com/dashboard",
    "title": "Example Dashboard"
  },
  "data": {
    "title": "Example Dashboard"
  },
  "missingFields": []
}
字段缺失响应示例 此可选字段示例会使 Quickstart 的 jq 校验失败。若将字段标为 required,则可能返回 HTTP 422 与 SPA_REQUIRED_FIELDS_MISSING。
{
  "mode": "extract",
  "page": {
    "url": "https://example.com/dashboard",
    "title": "Example Dashboard"
  },
  "data": {},
  "missingFields": [
    "title"
  ]
}
如何确认结果可用 Quickstart 在使用结果前会拒绝缺失或空的 title,以及非空的 missingFields 列表。 选择器未匹配时,检查目标页面结构和受支持的等待条件;不要拿 page.title 替代请求提取的字段。 单独处理非 2xx 响应,--fail-with-body 会暴露 HTTP 错误。不要将 API Key、请求正文或提取内容写入公开日志。 04 / 限制与计费
接入前需要了解 注册获 500 一次性积分。Hobby、Starter 和 Pro 每月分别为 9、49 和 199 美元。启动持久云浏览器需要付费套餐。
比较套餐与额度 → 目标网站改版可能导致选择器失效,不能假设每次请求都能返回所有字段。 页面就绪时机取决于目标网站,请在接口支持范围内设置等待条件。 多步导航、点击和表单操作应使用 Remote CDP,字段提取不能替代浏览器脚本。 请求消耗账号额度并受并发限制,批量调度前请确认套餐。 API Key 仅保存在服务端。遇到 HTTP 402 请检查额度,遇到 429 请降低并发并退避重试。
05 / FAQ
常见问题 应该使用 /html 还是 /spa-extract? 需要渲染 HTML 或可读正文时使用 /html;需要指定 DOM 或受支持的网络字段时使用 /spa-extract。
选择器未匹配时怎么办? 检查 missingFields 和返回数据,核实当前选择器与等待设置。目标网站结构改变后需要更新字段定义。
请求成功就代表数据正确吗? 不代表。入库前需要检查必要字段、类型和业务规则,页面渲染与提取不会验证原文事实。